
Index2.5 TTS语音克隆软件整合包
语音克隆软件
AI整合包
5 分
V2.5
11G
2026-09-19 更新
已下载 5 次
软件截图
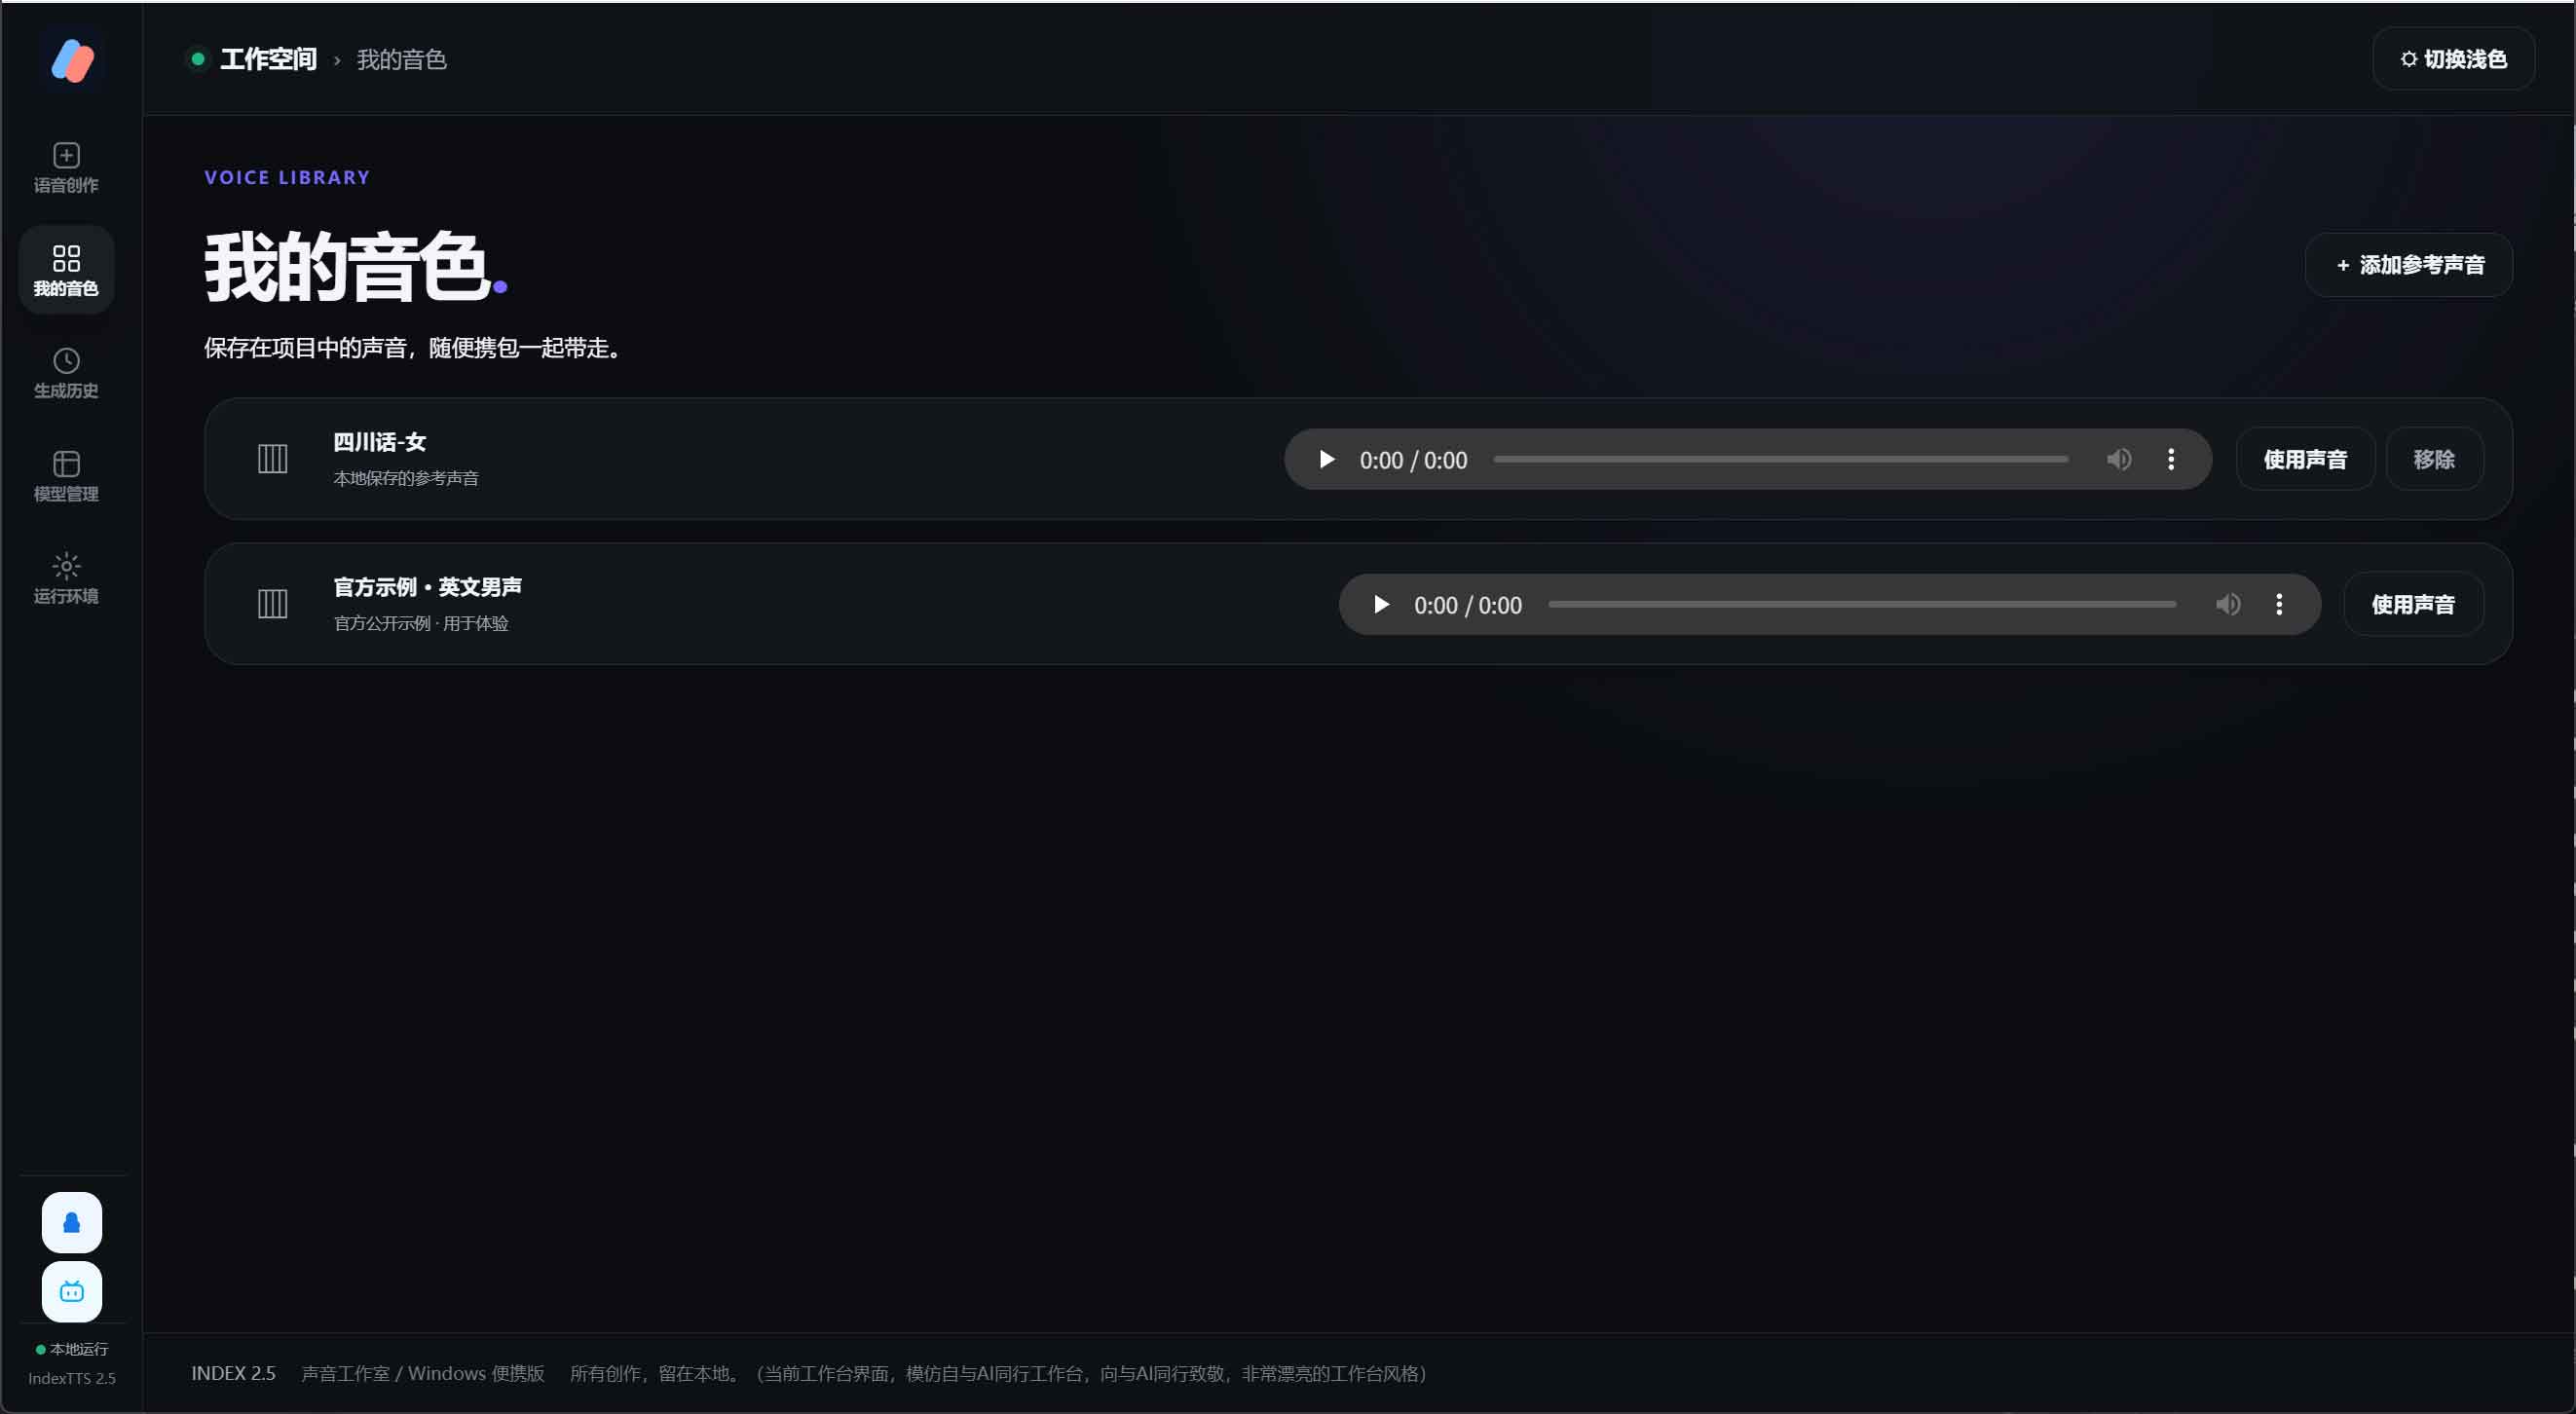
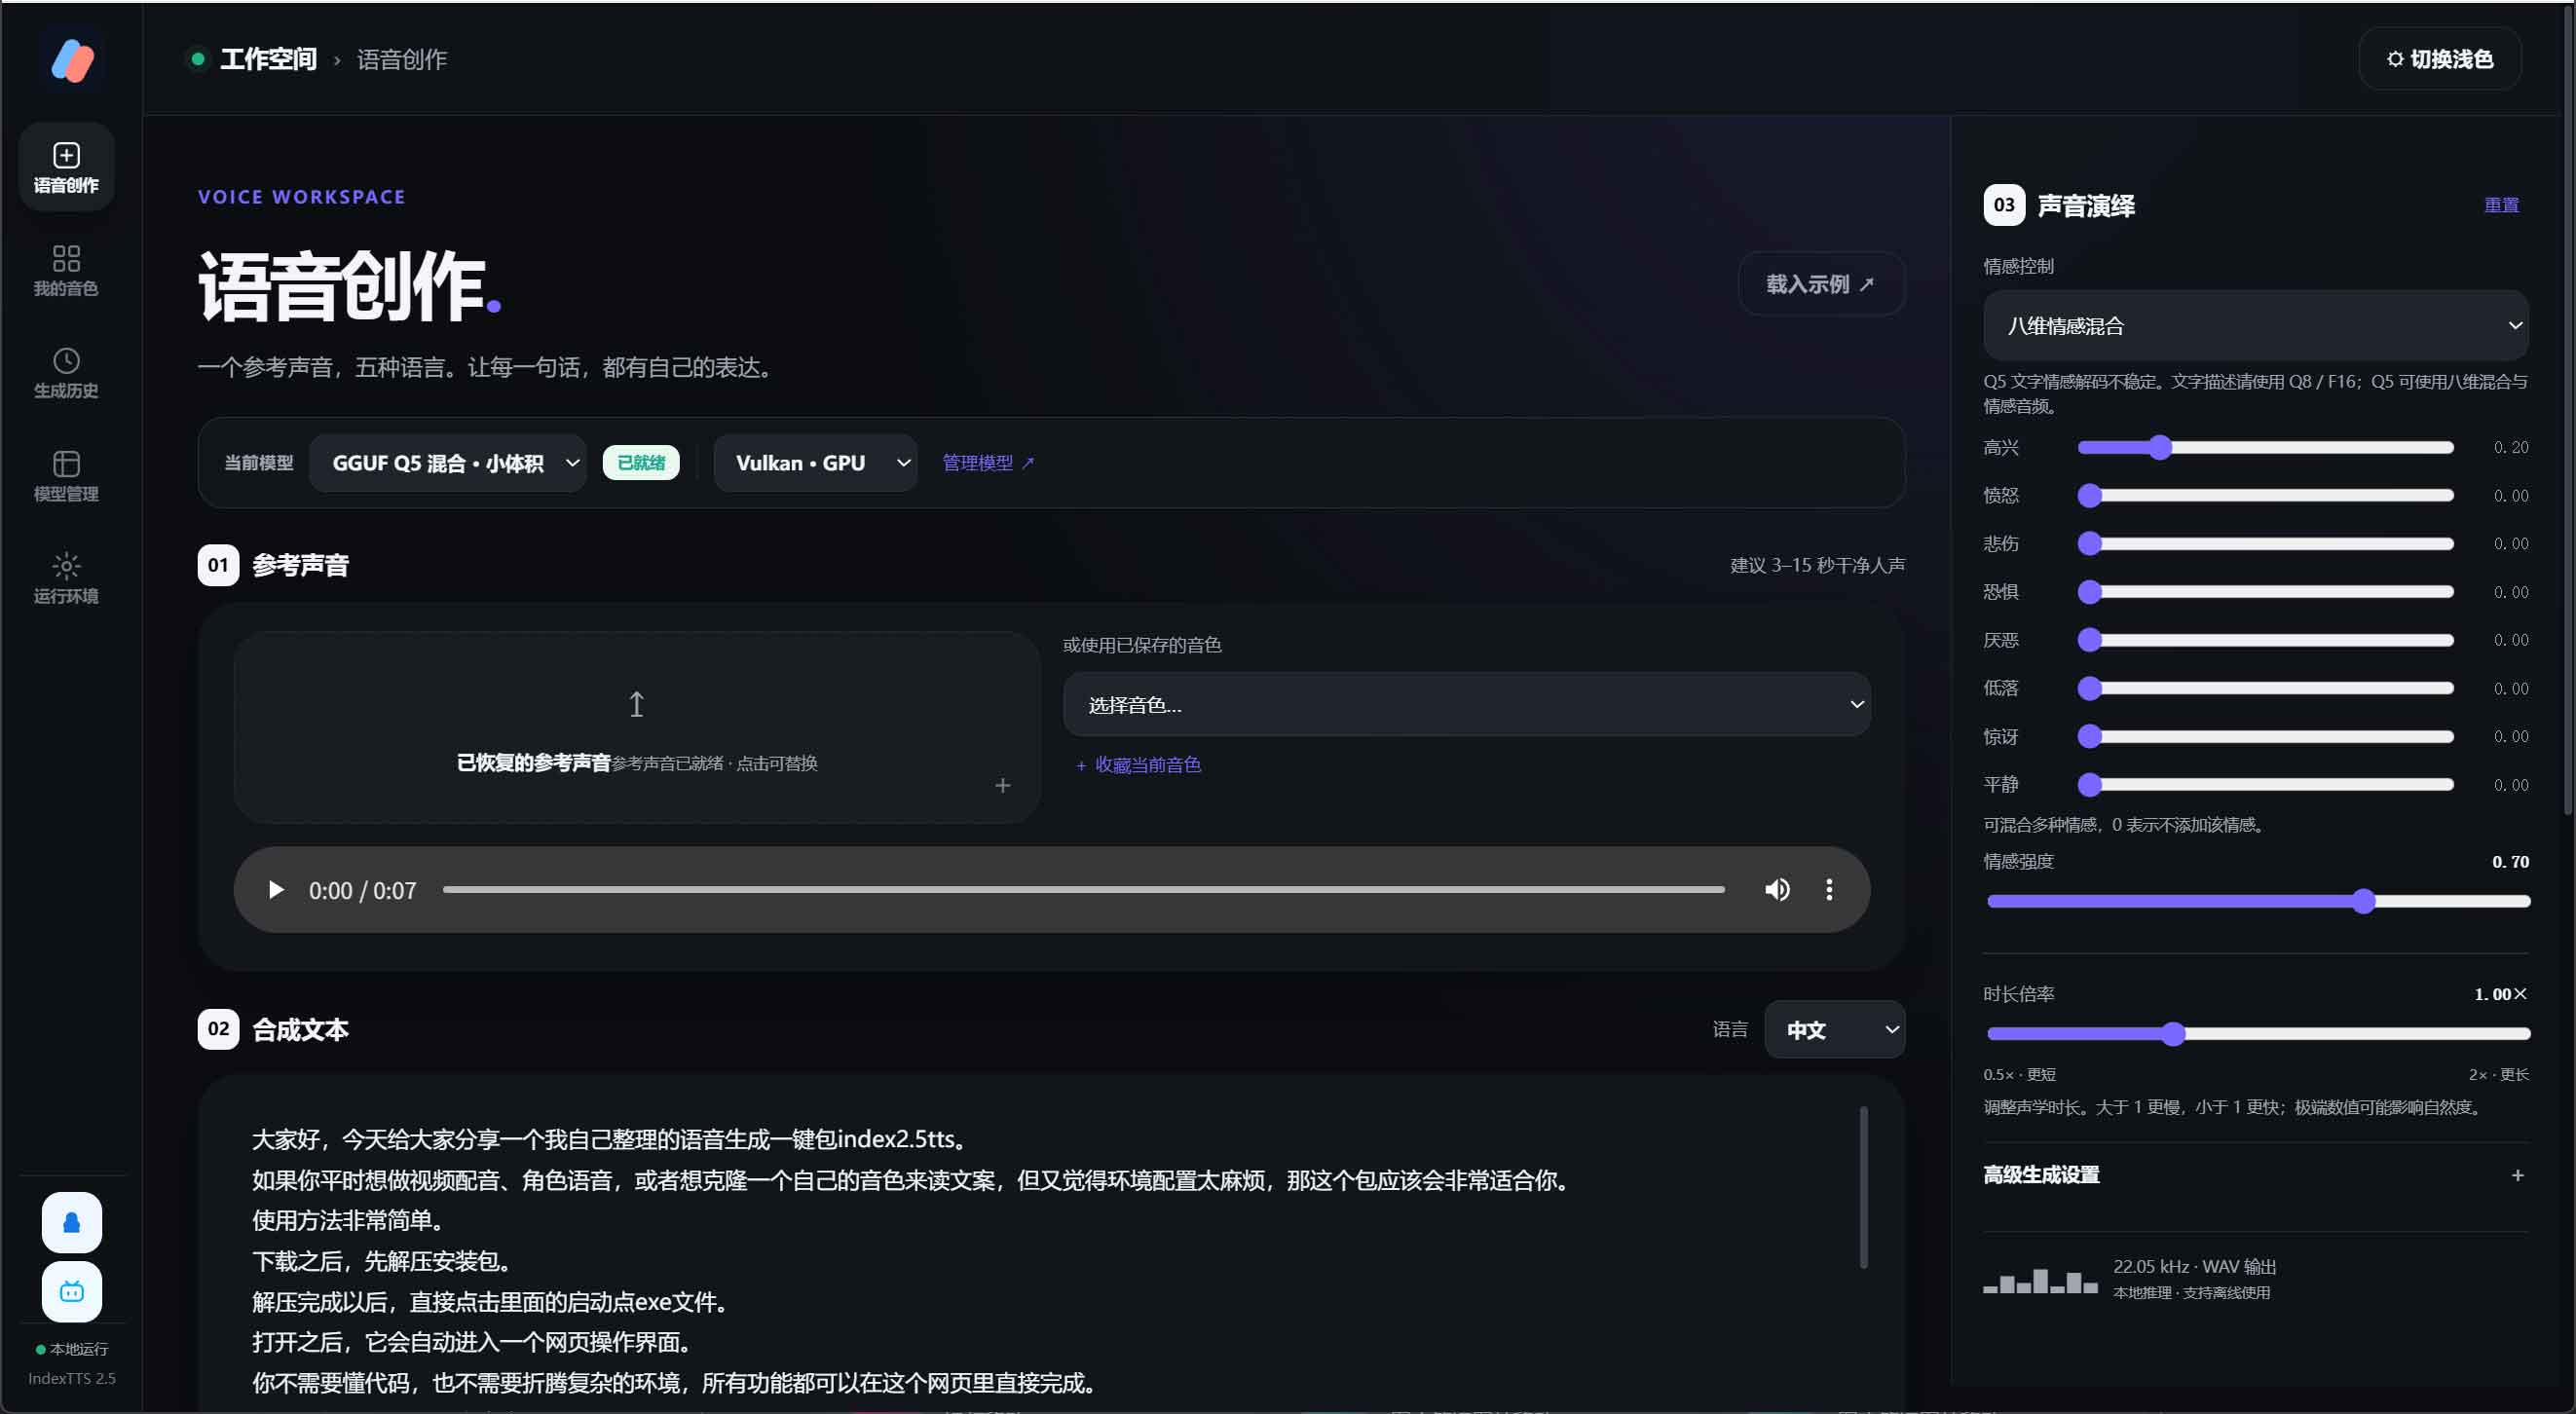
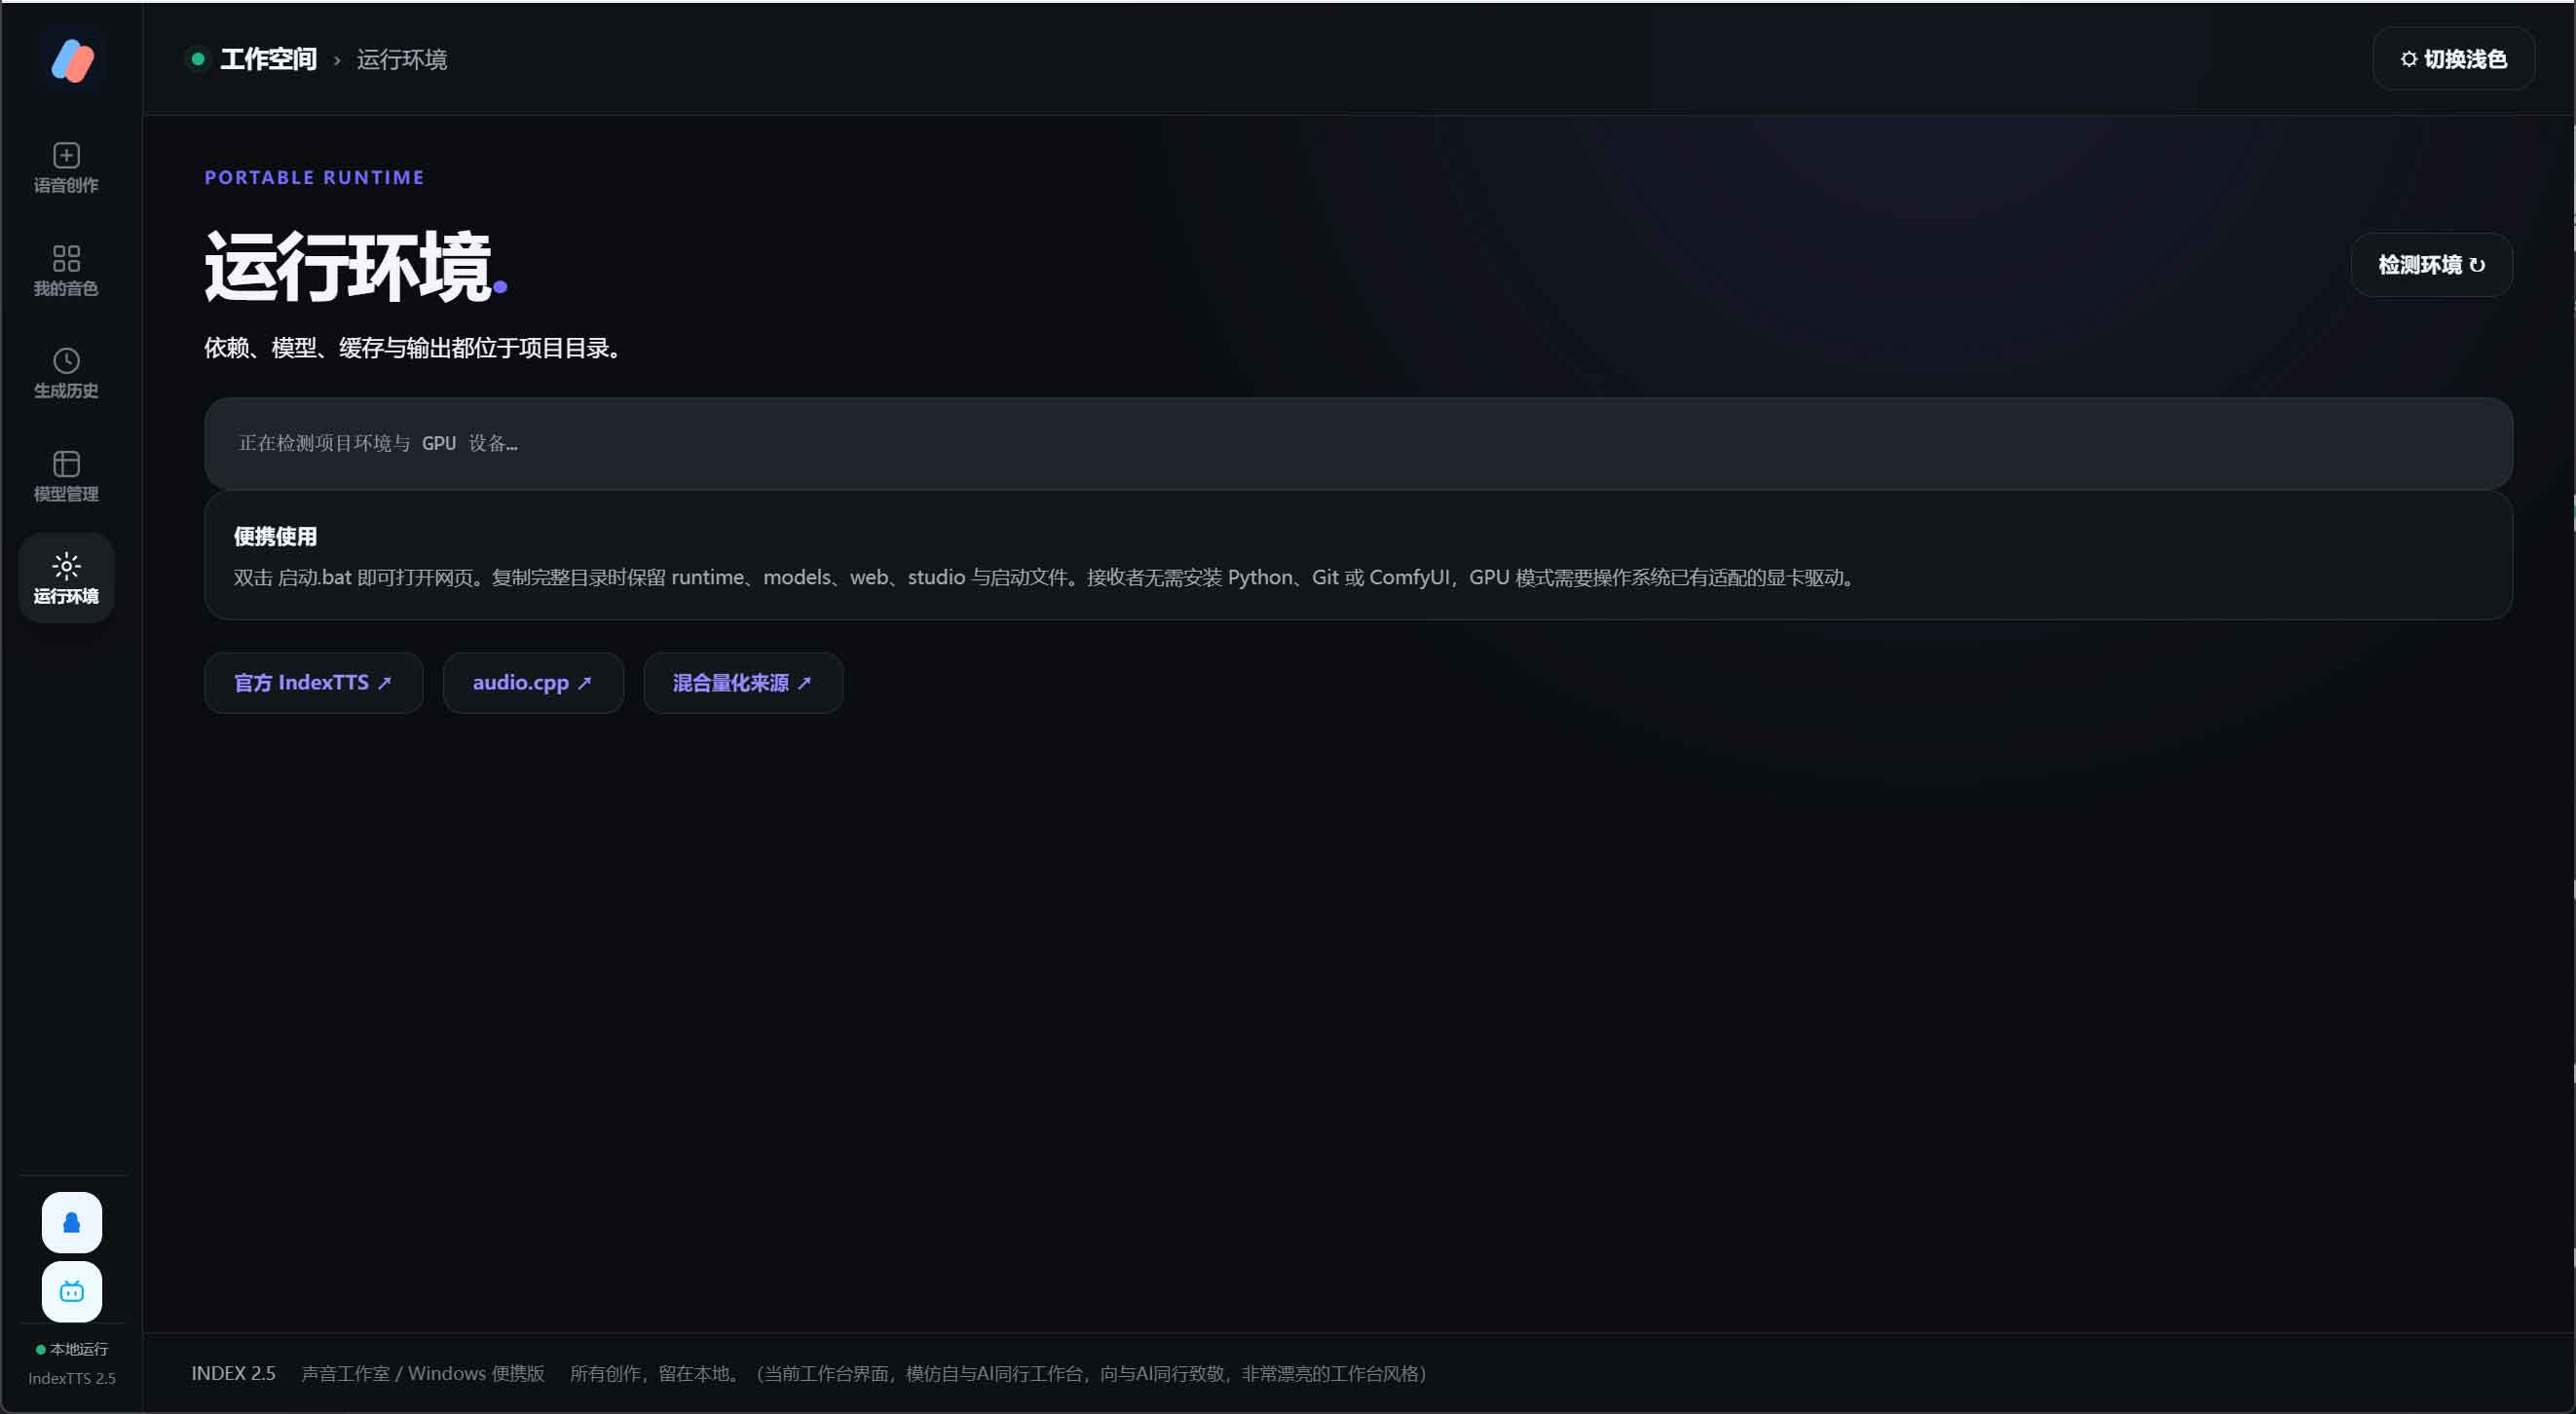
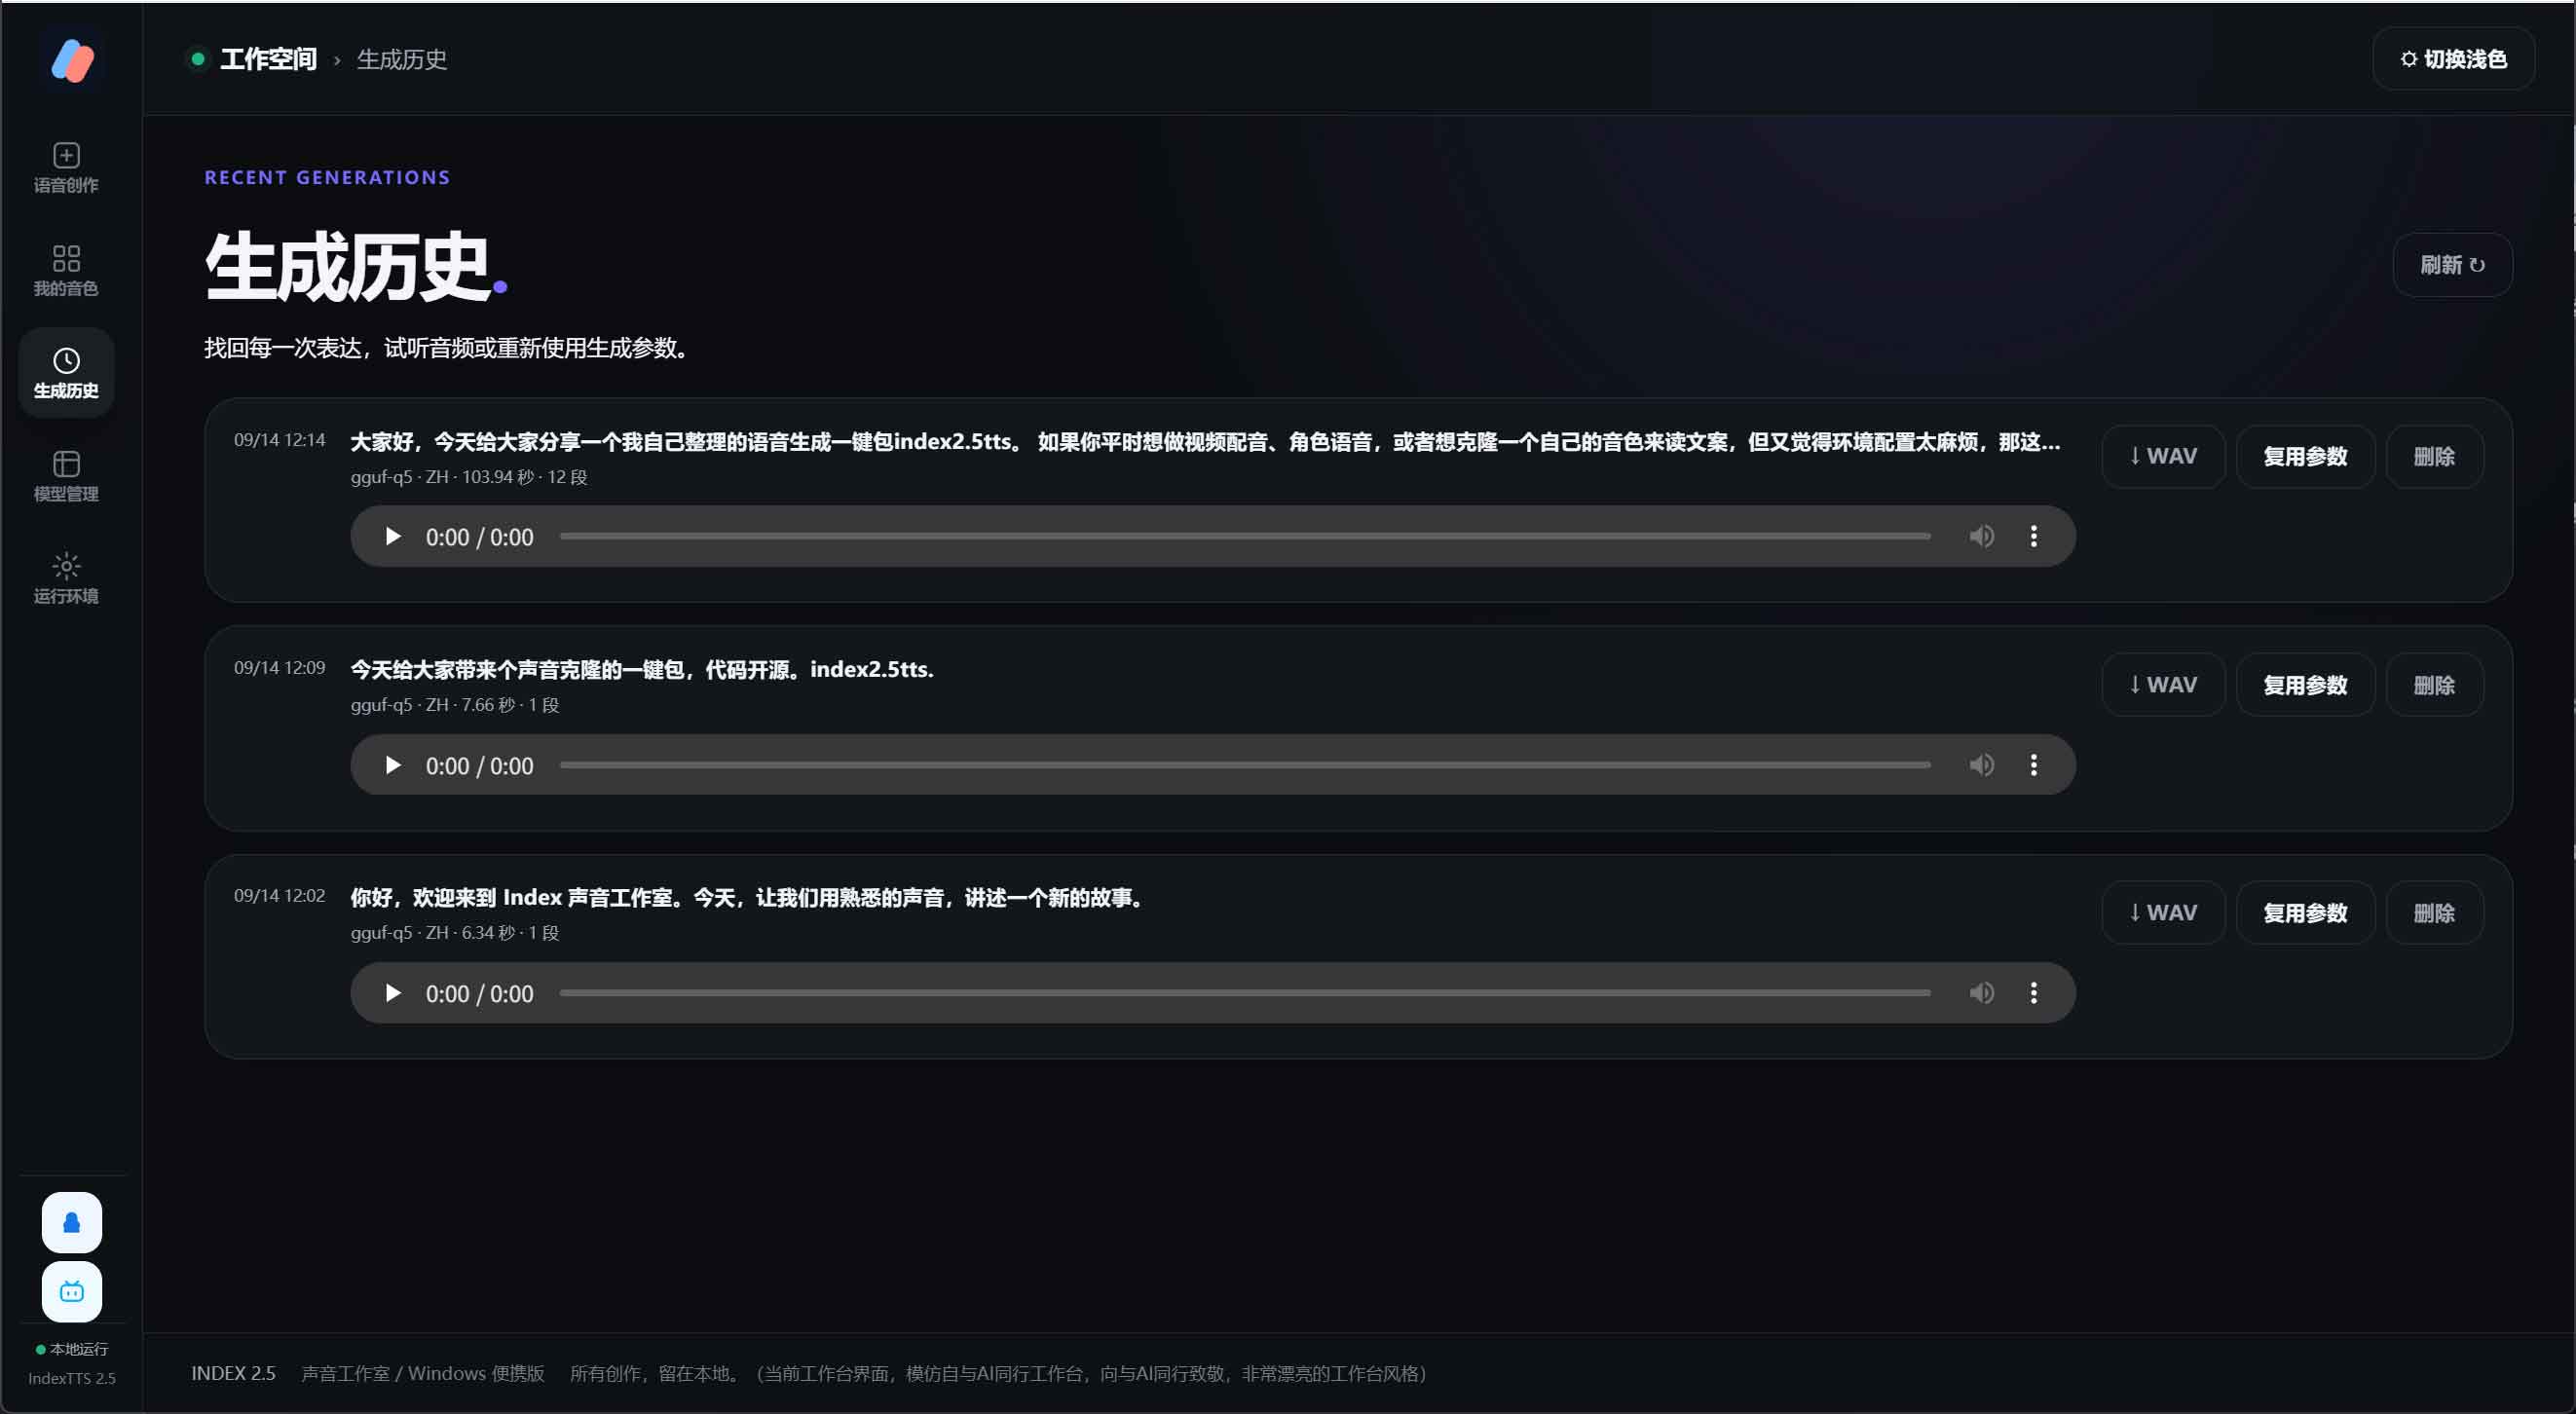
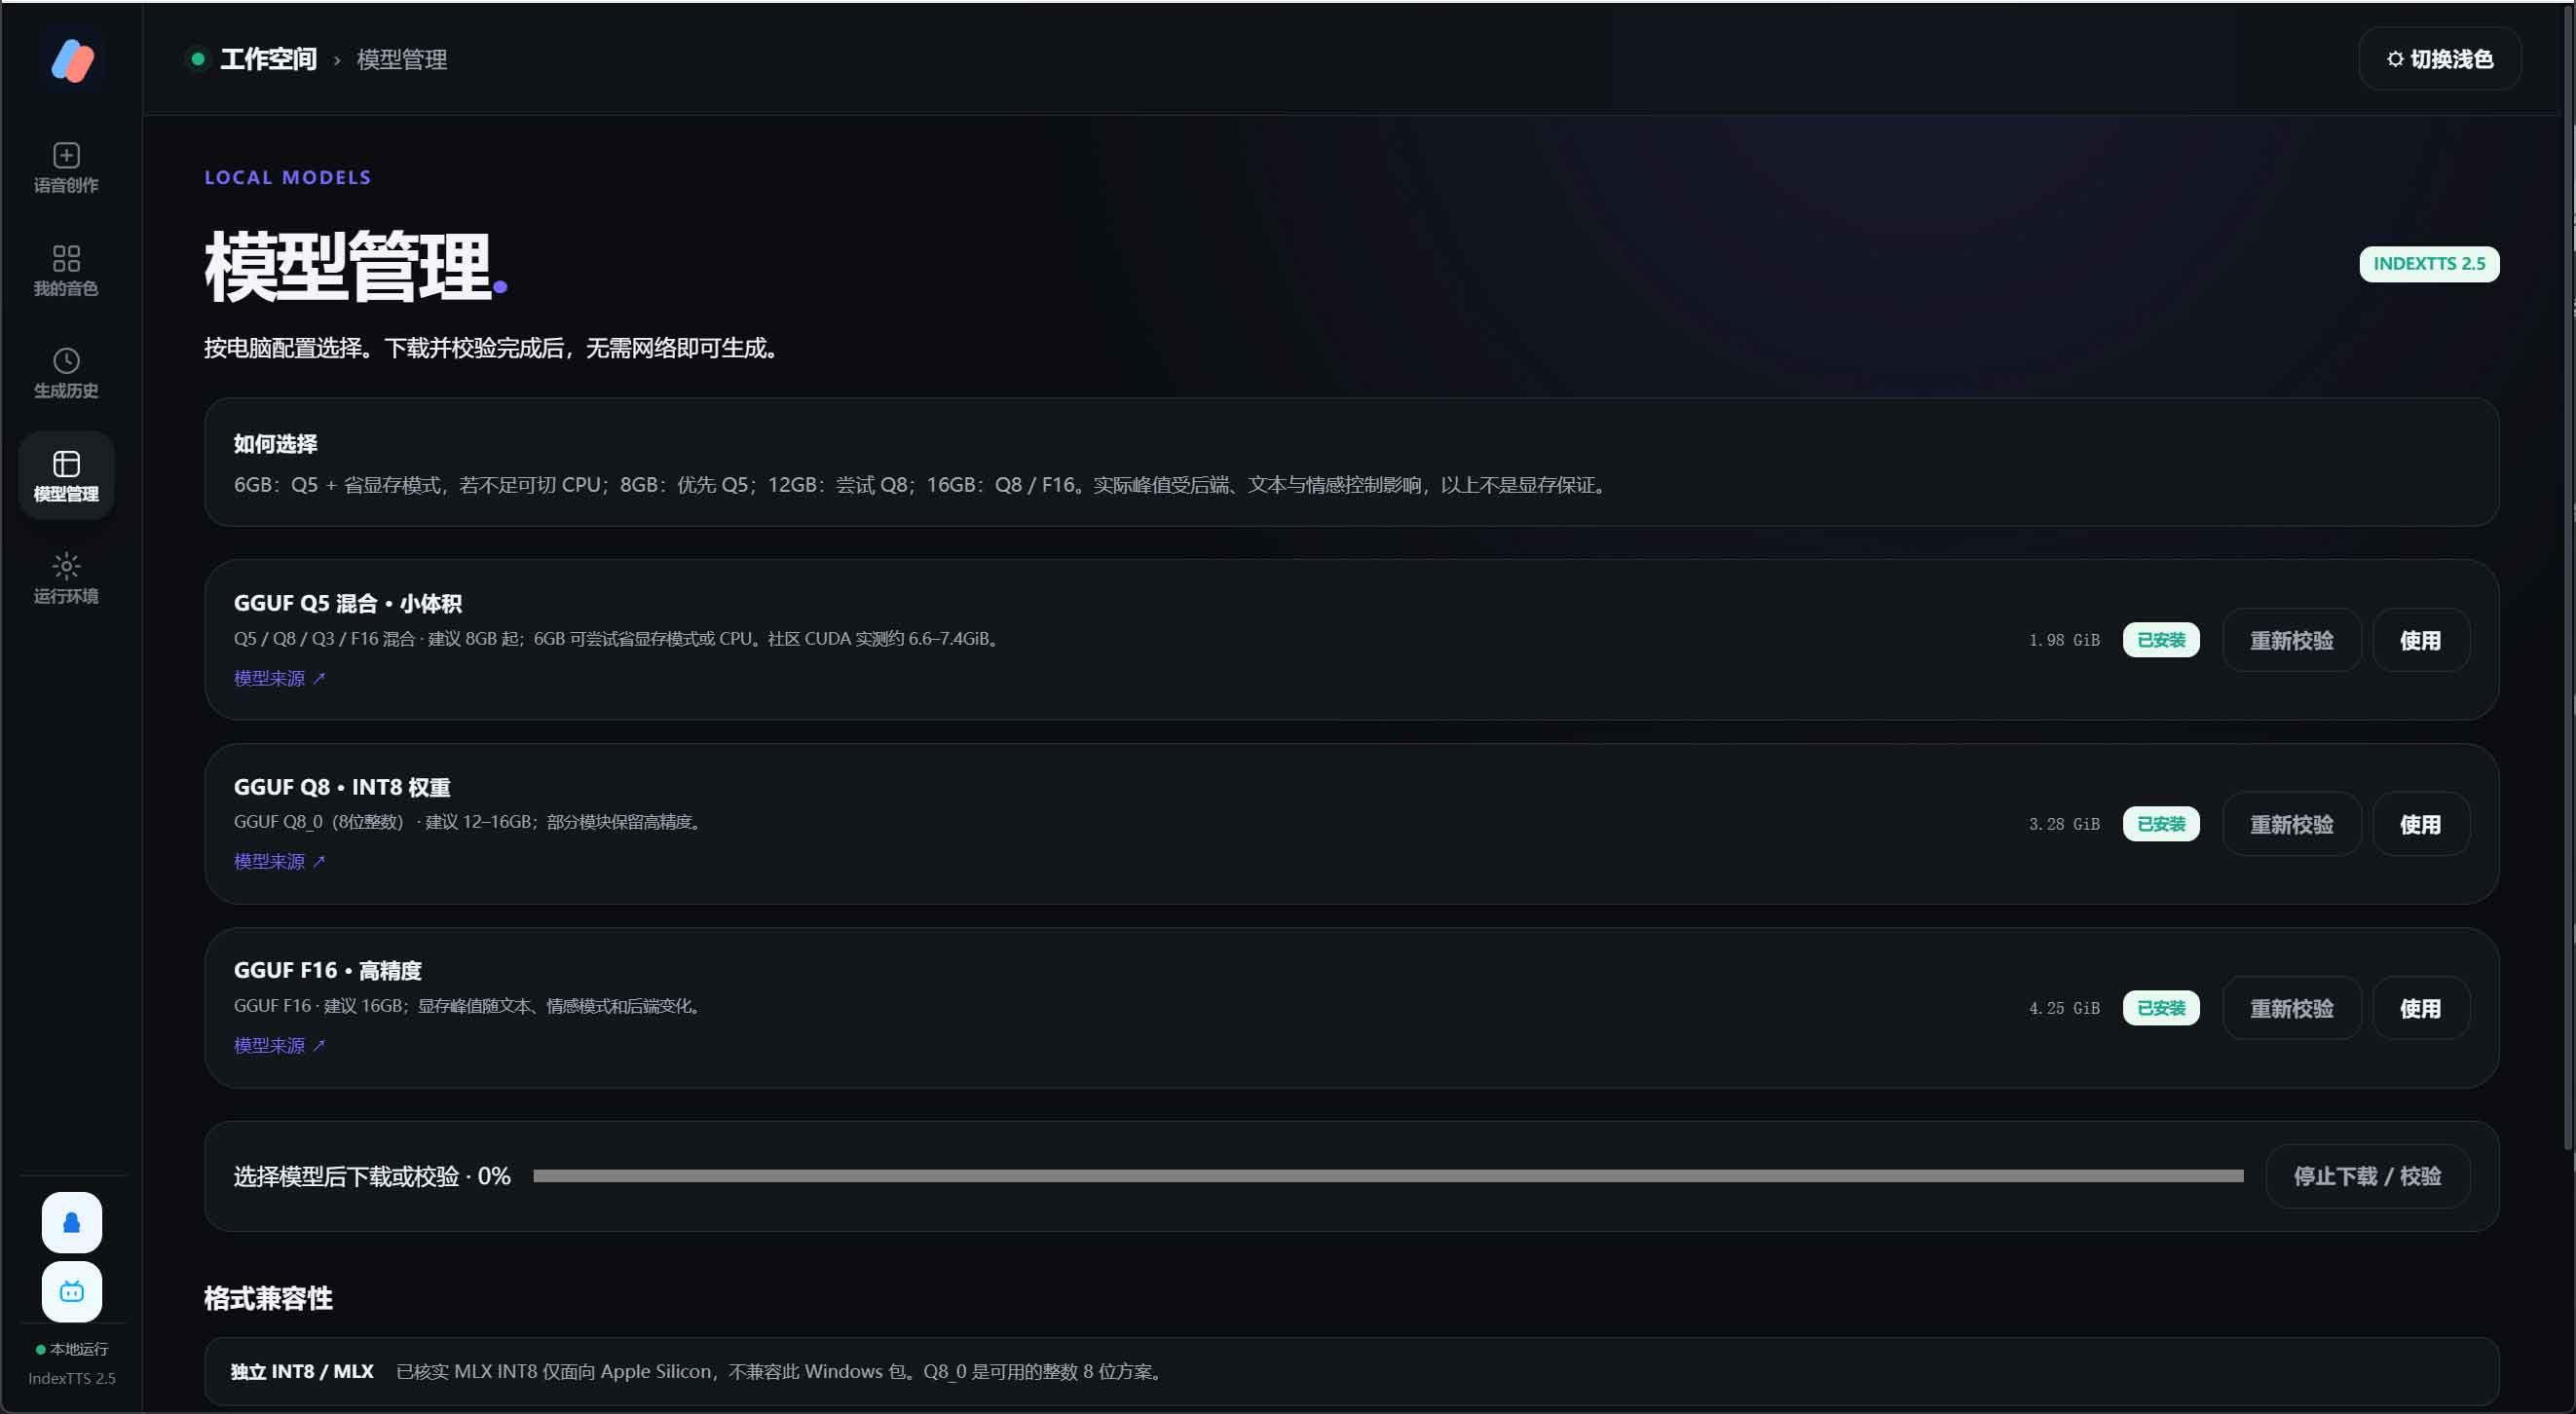
软件介绍
IndexTTS 2.5 是 Bilibili IndexTeam 推出的零样本语音合成系统,核心能力是“一段参考音频即可克隆音色”,并在此基础上强化了多语言、情感与语速的控制力。
核心功能
多语言合成与跨语言迁移:支持中文、英文、日语、西班牙语、阿拉伯语。你拿一段中文参考音频,可以让它以原音色直接说英文或日文,这对于需要制作多语种内容的创作者来说比较实用。
音色与情感的独立控制:这是 IndexTTS 系列一直保持的优势。你可以分别指定“用谁的声音说”和“用什么情绪说”。具体方式有三种:上传一段情感参考音频来复刻情绪、通过 8 维向量滑条手动配比(高兴/愤怒/悲伤/恐惧/反感/低落/惊讶/平静)、或者输入一段情感描述文本让模型自动理解。
精准的发音控制:针对多音字和特殊发音,2.5 版本增强了遵循能力。你可以在文本中直接嵌入标注,比如中文拼音 银<行|XING2>里<行|HANG2>走,英文 CMU 音素 a <minute|M IH1 . N AH0 T>,或者日语假名 料理が<上手|じょうず>,模型会按你的指定来读。
语速控制:通过 duration_factor 参数调节,范围 0.5–2.0。大于 1.0 变慢,小于 1.0 变快,方便对齐视频时长或适配不同场景的节奏。
推理加速:相比 IndexTTS 2,2.5 版本在架构上做了优化(语义 Codec 帧率减半、S2M 模块换用更轻量的 Zipformer),整体推理速度约提升至 2 倍以上,同时保持音质无明显下降。
主要使用方式
WebUI:通过 uv run webui.py 启动,浏览器访问 127.0.0.1:7860 即可进行音色克隆、情感调节和语速控制。
Python API:适合集成到自动化脚本中,基础调用约三行代码。
vLLM 部署:官方推荐的生产环境部署方案,适合需要高并发服务的场景。
需要注意的限制
模型在长文本处理上会分段合成再拼接,段与段之间会插入短暂静音,因此跨段落的韵律连贯性不如单段自然。另外,模型的参考音频需要用户自行确保获得说话人授权。
如果你有具体的使用场景(比如做有声书、视频配音),可以告诉我,我帮你看看哪个功能组合更适合。
下载地址
网盘下载
网盘下载
相关推荐